实验一 · nanochat
Raven 改了 7 轮训练代码:同样训练 20 分钟,模型猜得更准了
nanochat 是一个训练小型语言模型的项目。规则固定:一张 A800 显卡,每次只训练 20 分钟。Raven(由 DeepSeek v4.1-flash 驱动,装了 ai4ai 插件)每一轮读上一轮的结果,自己修改训练代码 train.py,再提交新的训练,一共 7 轮。
val_bpb,越低越好
官方 train.py 的起点是 0.9956;第 7 轮的最终方案是 0.9381(3 次不同随机种子训练的平均,±0.0007),降低了 5.8%。
train.py 的起点。鼠标移到点上可以看具体数值。还没到头:实验停下,是因为 GPU 时间用完了,不是成绩不涨了
最后两轮(第 6、7 轮)每一轮的进步都远大于随机波动(0.0013),曲线还在往下走。7 轮一共训练 172 次,没有一次崩溃,用掉了 3600 GPU 分钟预算里的 3586 分钟。
val_bpb 是什么
它衡量模型读到没见过的文字时有多“意外”:让模型逐个预测下一个字,把预测的不确定程度折算成“每个字节多少比特”。数越低,说明模型猜得越准。
最终方案比官方代码改了哪 7 处
- 每一步喂给模型的数据量减半(batch 219 → 218),20 分钟里能走的步数从 1540 增到 3055
- 新加一张可学习的查表,专门记“前后两个 token”的组合,行数是词表的 100 倍(819200 行)
- 查表的结果在第 0 层之后就加进模型
- 学习率
MATRIX_LR从 0.04 降到 0.02 - 注意力的短窗口从 1024 缩到 256
- 模型加宽:
ASPECT_RATIO64 → 80(宽度 512 → 640) - 评测时的 batch 固定为 128
查看每一轮的最好方案
| 轮次 | 方案 | val_bpb | 种子 | GPU 分钟 |
|---|
说明:最终方案目前只有 3 个种子,Raven 在报告里建议补到 7~8 个。模型加宽后每一步慢了约 30%,20 分钟里的步数从 3055 降到 2363,但分数仍然更低,这是固定时间下的净效果,符合规则。“真改进”的标准是和上一轮最优相比 Welch |t| > 3 且 |Δ| > 0.002;第 1 轮 9 个候选都没过,从第 2 轮起每轮都有新的最优。
实验二 · CFD 溃坝模拟
为了提速连崩三次,它退回稳妥设置,再把误差一轮轮压小
CFD(计算流体力学)是用计算机模拟液体和气体的流动。这场实验用开源软件 OpenFOAM 模拟二维溃坝:一堵水柱突然倒下,冲向对面的墙。同一个算例、81648 个网格,一共跑了 7 轮(第 0~6 轮)。每个网格里记着“这里有多少比例是水”(软件里叫 alpha),只能在 0 到 1 之间;算成负数或大于 1,就是不合物理的误差,叫“越界”。
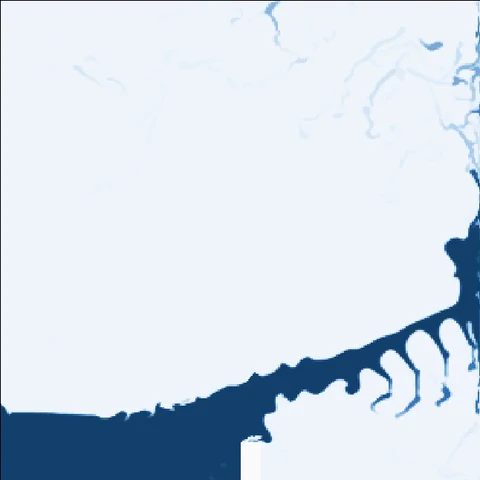 第 0 轮稳妥设置,跑到终点
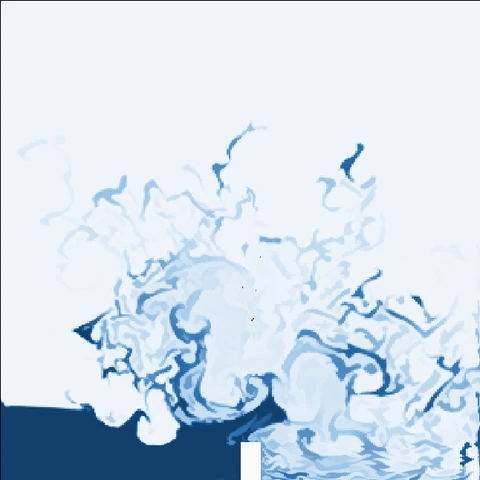 第 1 轮提速,t=0.4 算崩
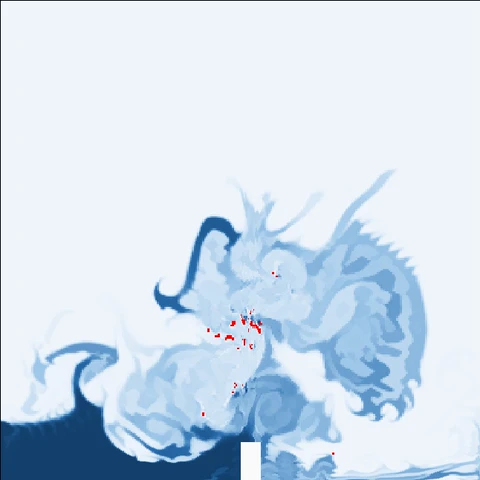 第 2 轮再提速,t=0.5 算崩
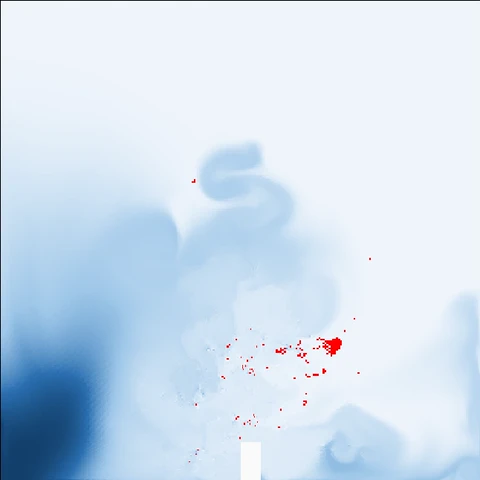 第 3 轮再提速,t=0.65 算崩
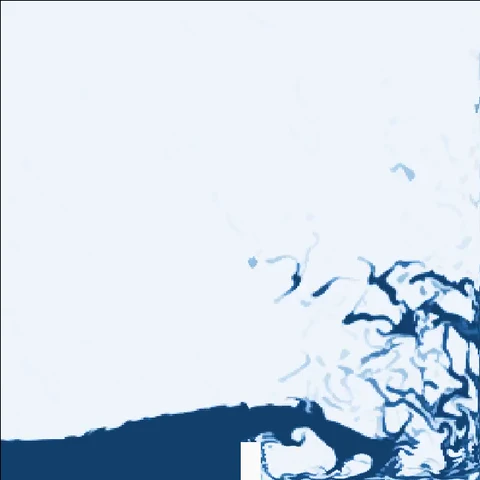 第 4 轮退回稳妥,跑到终点
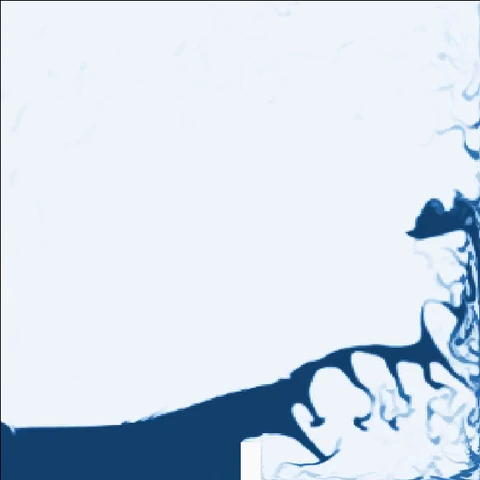 第 5 轮误差更小,水面变糊
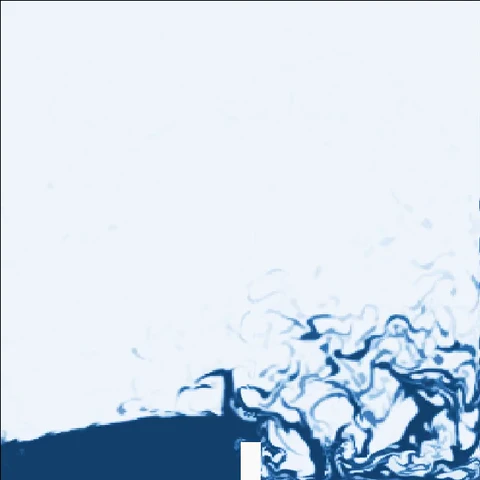 第 6 轮误差最小
先想提速:步子越迈越大,三次都半路算崩
第 1~3 轮把每一步往前算的时间一次比一次放大(软件里的 maxCo,从 1 放到 20、100、500),越界的格子从 0 个冒到 241、3877、1241 个,三轮都没算到终点。
再退回稳妥:误差一轮比一轮小,但还没到零
第 4 轮把 maxCo 退回 1,跑到终点,水量守恒;第 5、6 轮改进算水面的方法,越界幅度一路变小。判据要求水的占比严格在 0 到 1 之间,浮点计算做不到这一点:第 4~6 轮都只差 1e-7~1e-10,仍判为未通过。
查看每一轮改了什么
| 轮次 | 改了什么 | 结果 |
|---|
说明:越界格数和越界幅度由渲染脚本测得;Raven 自己报告的数值测量位置不同,页面统一用前者。第 4 轮记录的是 alpha 最小值 −1.97e-07,图上按幅度画成 1.97e-07。
实验三 · FEA 悬臂梁仿真
像猜数字一样对半试探,8 轮逼近软件“算不动”的临界点
这是软件的计算极限,不是梁真能扛住的力。FEA(有限元分析)是用软件把结构切成很多小块来算受力。这场实验(2026-08-17)用开源软件 CalculiX 给一根一端固定的梁加载荷:载荷越大越难算,大到一定程度,软件就“不收敛”,也就是反复迭代也算不出结果。Raven 用二分法找这个临界点:算得出就加力,算不出就减力,每次取两者中间。
先大步,再对半
第 0 轮 2000 kN 算不出,第 1 轮降到 1800 kN 算得出;之后每轮都取“最大的算得出”和“最小的算不出”的中间值。
最后夹在两个载荷之间
1962.5 kN 还算得出,1965.625 kN 算不出。实验记录为“二分法收敛”、正常完成,全过程 107 条事件记录。
梁本身扛不了这么大的力
按材料和截面算,这根梁的理论塑性极限只有 62.5 kN,8 轮的载荷都远远超过它。约 1962.5 kN 只是软件还能算完的最大载荷。
查看每一轮的载荷和结果
| 轮次 | 载荷 (kN) | 结果 | 机时 |
|---|
实验四 · AI4AI 成本对比
Raven 配便宜模型:花的钱少得多,成绩依然排在前面
这是另一场实验,预算规则和 nanochat 板块不同,数字不能互相比较。任务:用 nanochat 准备一个 50M 预训练模型,比 BPB(预测文字的误差,越低越好;A800 基线 1.108)。Raven 或 Claude Code 各配一个模型,在两种预算下各比一次。
- Raven · V4.1(便宜模型)
- Raven · 其他模型
- Claude Code · Opus 5(对照)
只给 5 小时,钱不设上限
成绩同在 1.037 量级,成本差 40 倍。V4.1 花 $0.97,Opus 5 花 $39.41。同用 Opus 5,Raven 1.038,Claude Code 1.053。
只给 50 美元,时间不设上限
只花 $6.12,拿到全场最好的 0.965。贵模型三组都花光了额度;V4.1 便宜,能跑 80 多小时,探索得更多。
查看两种预算的完整数据
| 框架 · 模型 | 耗时 | token | 成本 | BPB |
|---|
| 框架 · 模型 | 耗时 | token | 成本 | BPB |
|---|
harness 的作用不是让模型更聪明,而是让模型稳定地工作。
不信模型自述,只信可核对的证据。
Raven 是怎么做到的
- 多智能体编排
- 按契约交接产物,不做观点协商;写代码与跑实验分开,测量不被污染;共享记忆支撑长程,同时省 token。
- Research
- 按预算、取回量、充分性动态调策略;难易判断基于已取回的证据,不是先验。
- Code
- 实现之外加独立验收与测试;客观信息由工具机器读取,不取模型陈述。
- 值守
- 自主提交、排时间查看、决策重做或终止;自写定时器、心跳与会话保持。
- ai4ai 流程
- 提出方向(DR + 广度优先)→ 实现 → 验证有效性 → 实测 → 带证据地结束,或深度优先下探。
- 方案种子库
- 记录已试过与未试过的方向,让 Raven 了解现状,并能探索与组合新方向。